【Java】Java 基础语法
Java 概述
谈谈你对 Java 平台的理解?“Java 是解释执行”,这句话正确吗?
Java 本身是一种面向对象的语言,最显著的特性有两个方面,一是所谓的“书写一次,到处运行”(Write once, run anywhere),能够非常容易地获得跨平台能力;另外就是垃圾收集(GC, Garbage Collection),Java 通过垃圾收集器(Garbage Collector)回收分配内存,大部分情况下,程序员不需要自己操心内存的分配和回收。
我们日常会接触到 JRE(Java Runtime Environment)或者 JDK(Java Development Kit)。
- JRE,也就是 Java 运行环境,包含了 JVM 和 Java 类库,以及一些模块等。
- JDK 可以看作是 JRE 的一个超集,提供了更多工具,比如编译器、各种诊断工具等。
对于“Java 是解释执行”这句话,这个说法不太准确。我们开发的 Java 的源代码,首先通过 Javac 编译成为字节码(bytecode),然后,在运行时,通过 Java 虚拟机(JVM)内嵌的解释器将字节码转换成为最终的机器码(.class 文件)。但是常见的 JVM,比如我们大多数情况使用的 Oracle JDK 提供的 Hotspot JVM,都提供了 JIT(Just-In-Time)编译器,也就是通常所说的动态编译器,JIT 能够在运行时将热点代码编译成机器码,这种情况下部分热点代码就属于编译执行,而不是解释执行了。
严格的讲,跨平台的语言不止Java一种,但Java是较为成熟的一种。“一次编译,到处运行”这种效果跟编译器有关。编程语言的处理需要编译器和解释器。Java虚拟机和DOS类似,相当于一个供程序运行的平台。
程序从源代码到运行的三个阶段:编码——编译——运行——调试。Java在编译阶段则体现了跨平台的特点。编译过程大概是这样的:首先是将Java源代码转化成 .class 文件字节码,这是第一次编译。.class 文件就是可以到处运行的文件。然后Java字节码会被转化为目标机器代码,这是是由JVM来执行的,即Java的第二次编译。
“到处运行”的关键和前提就是JVM。因为在第二次编译中JVM起着关键作用。在可以运行Java虚拟机的地方都内含着一个JVM操作系统。从而使JAVA提供了各种不同平台上的虚拟机制,因此实现了“到处运行”的效果。需要强调的一点是,Java并不是编译机制,而是解释机制。Java字节码的设计充分考虑了JIT这一即时编译方式,可以将字节码直接转化成高性能的本地机器码,这同样是虚拟机的一个构成部分。
Java 数据类型
基本数据类型:
- 整型:
byte \ short \ int \ long - 浮点型:
float \ double - 字符型:
char - 布尔型:
boolean
引用数据类型:
- 类(
class) - 接口(
interfac) - 数组(
array)
容量
- 整型:
byte(1字节=8bit) \short(2字节)\int(4字节)\long(8字节) - 浮点型:
float(4字节) \double(8字节) - 字符型:
char(1字符=2字节)
注意:定义long型变量,必须以"l"或"L"结尾;定义float类型变量时,变量要以"f"或"F"结尾
整型常量默认为int类型,浮点类型常量默认为double类型。
自动类型提升
自动类型提升:当容量小的数据类型的变量与容量大的数据类型的变量做运算时,结果自动提升为容量大的数据类型。
byte 、char 、short --> int --> long --> float --> double
特别的:当byte、char、short三种类型的变量做运算时,结果为int型
float和double类型的变量相加时,结果为double类型。
强制类型转换
强制类型转换:从容量大的类型转换成容量小的类型。它是自动类型提升运算的逆运算。其中容量大小指的是,表示数的范围的大小。比如:float容量要大于long的容量
注意事项
- 情况1:编译不出错,因为右边的123456默认是
int类型,转给long类型时为自动类型提升(小转大,不出错)
1 | long num = 123456; |
- 情况2:编译出错——过大的整数。因为右边的数默认为int类型,但因为该数字过大超过了
int类型的范围,所以会报错。此时需要再其后面加上"l"或"L"。
1 | long num = 12345678987654321; |
- 情况3:编译出错——不兼容的类型:从
double转换到float可能会有损失。因为右边的12.3默认为double类型,不能直接转换,需要加上强制类型转换(float)12.3。此时需要再其后面加上"f"或"F"。
1 | float f1 = 12.3; |
- 情况4:编译出错——不兼容的类型:从int转换到byte可能会有损失。因为此时的 1 默认是int类型,不能直接转换,需要加上强制类型转换。
1 | byte b = 12; |
进制转换
二进制转十进制细节:https://www.bilibili.com/video/BV1Kb411W75N?t=470&p=64
计算机底层使用补码的方式存储数据
基本数据类型使用示例
1 | class VariableTest { |
数组
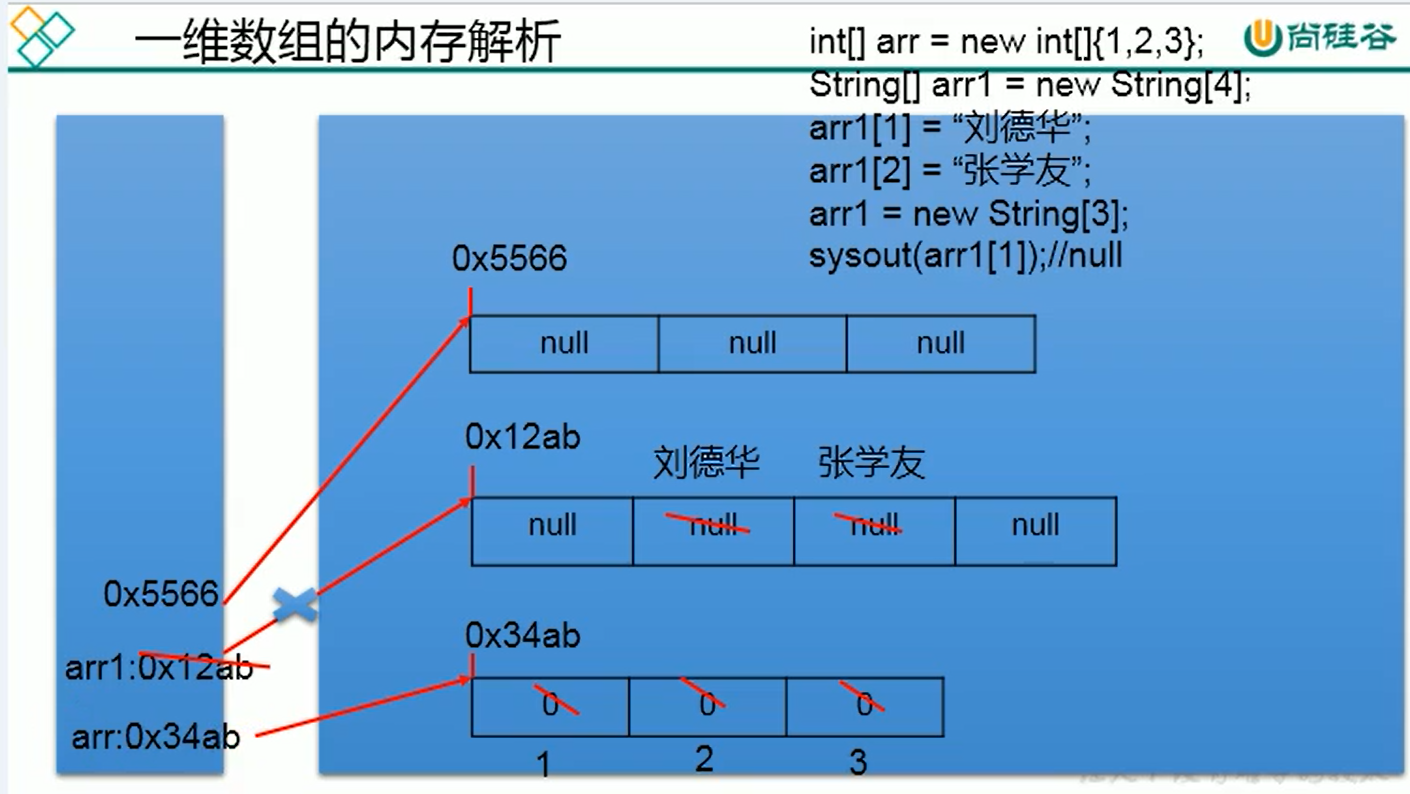
数组默认初始值
int[]类型:0double[]类型:0.0String[]类型:null
数组元素的默认初始化值
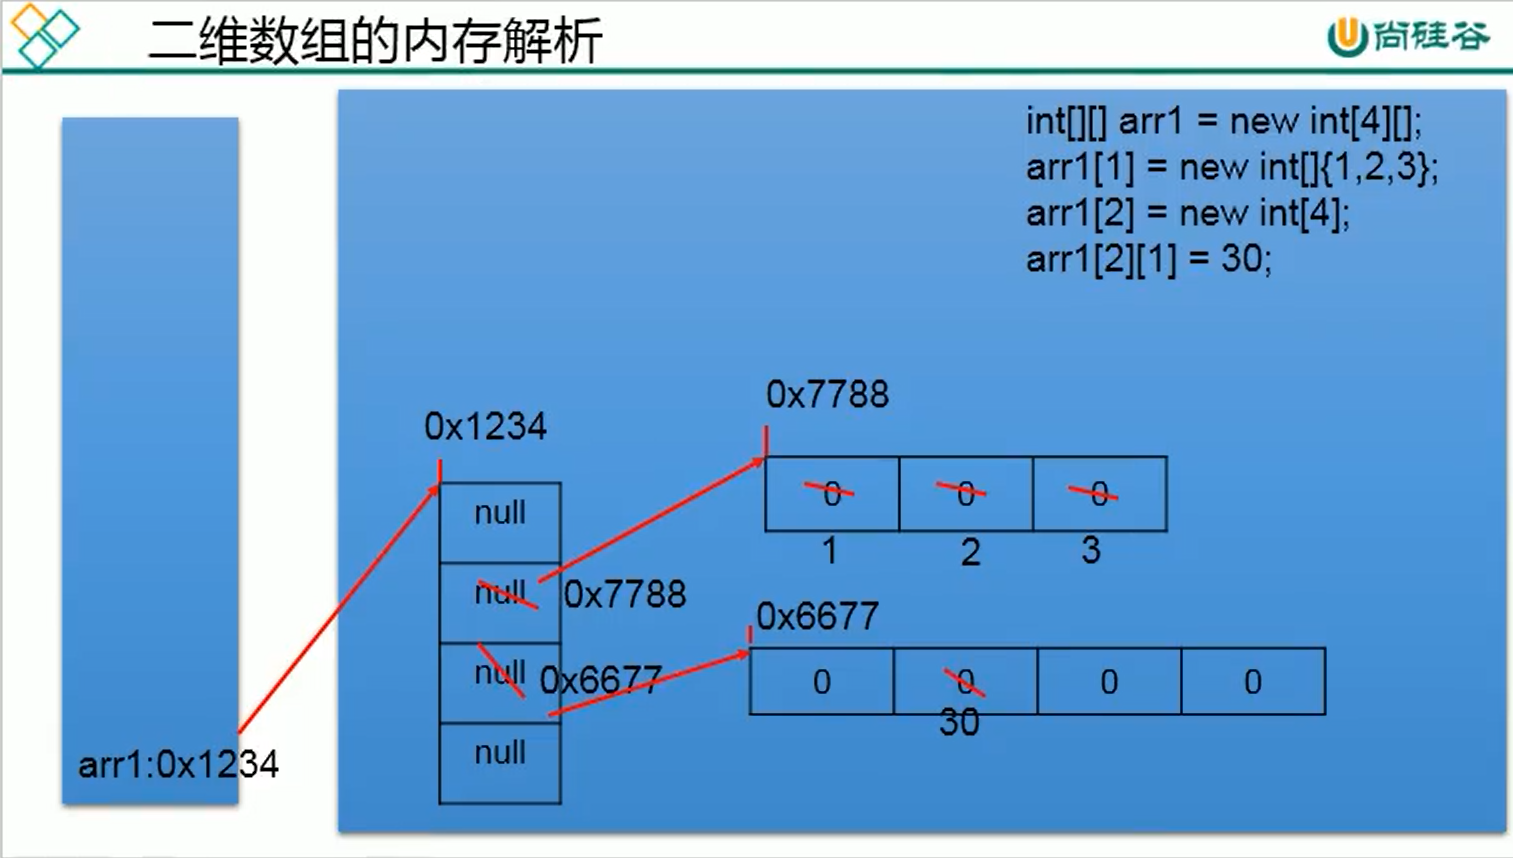
针对于初始化方式一:比如:int[][] arr = new int[4][3];
- 外层元素的初始化值为:地址值
- 内层元素的初始化值为:与一维数组初始化情况相同
针对于初始化方式二:比如:int[][] arr = new int[4][];
- 外层元素的初始化值为:null
- 内层元素的初始化值为:不能调用,否则报错。
1 | public class ArrayTest { |
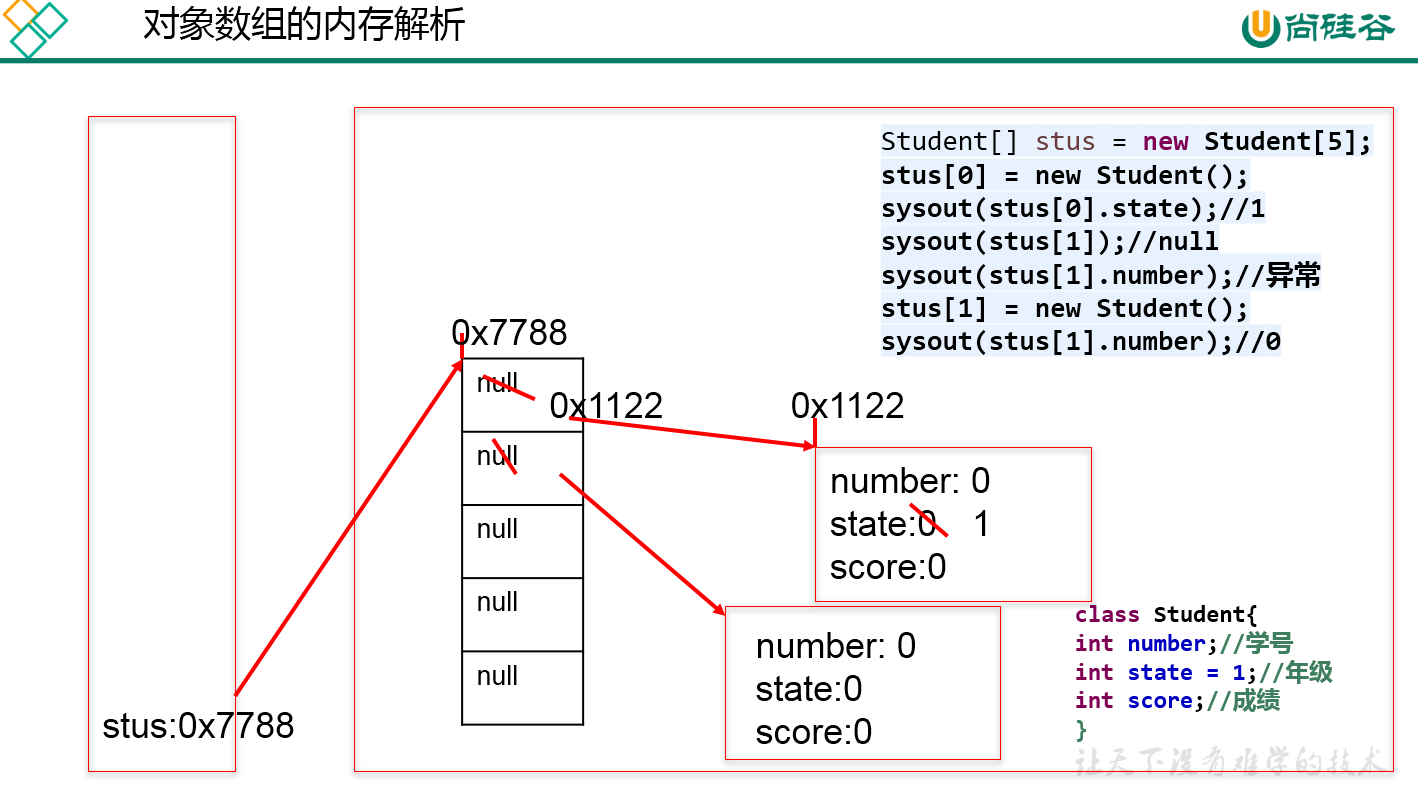
数组的内存解析
- 一维数组
- 二维数组
注意点
System.out.println对char[]数组的重载方法是打印其内容,其他类型数组打印的是地址值
1 | int[] arr = new int[]{1,2,3}; |
包装类
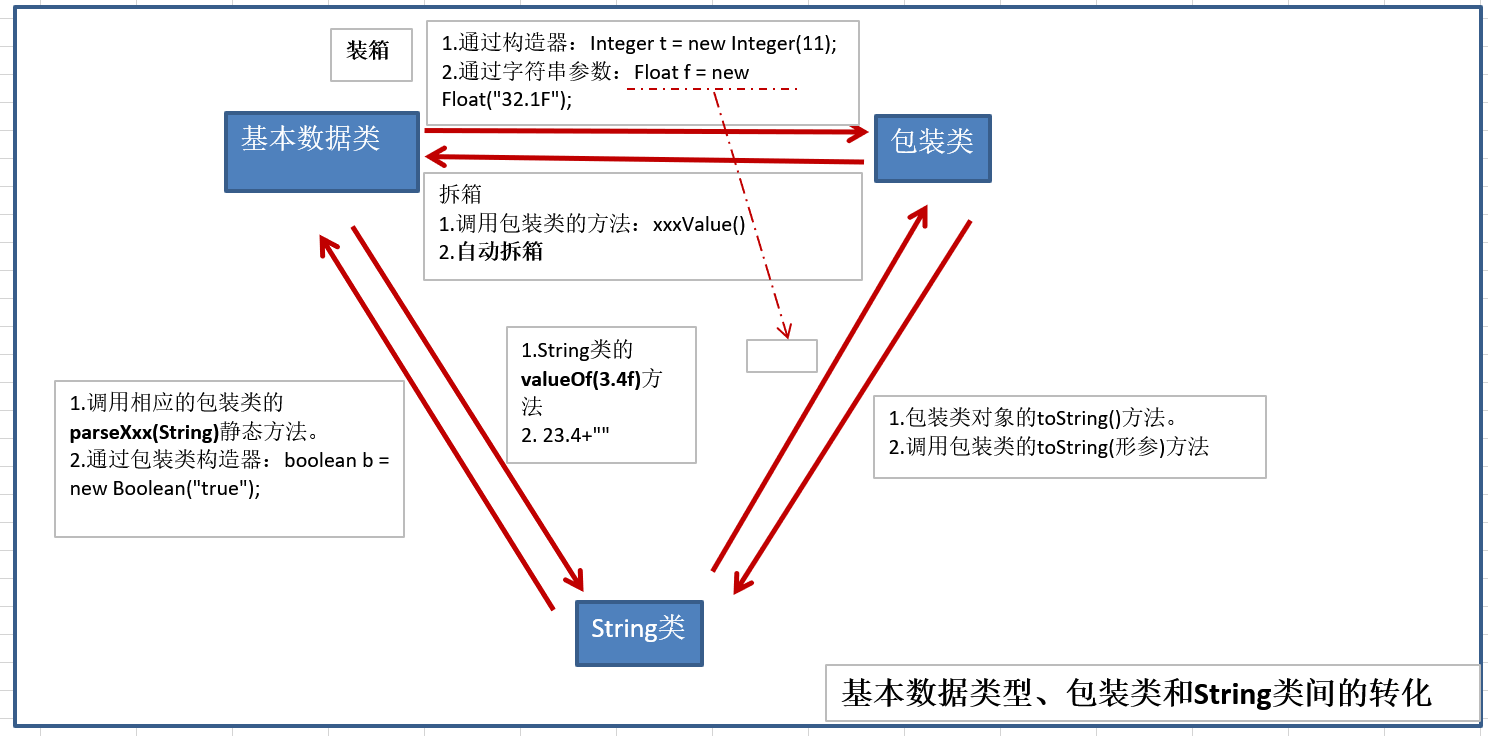
包装类的自动装箱实际上算是一种语法糖。什么是语法糖?可以简单理解为 Java 平台为我们自动进行了一些转换,保证不同的写法在运行时等价,它们发生在编译阶段,也就是生成的字节码是一致的。
javac 替我们自动把装箱转换为 Integer.valueOf(),把拆箱替换为 Integer.intValue()。
整体看一下 Integer 的职责,它主要包括各种基础的常量,比如最大值、最小值、位数等;前面提到的各种静态工厂方法 valueOf();获取环境变量数值的方法;各种转换方法,比如转换为不同进制的字符串,如 8 进制,或者反过来的解析方法等。
基本数据类型、包装类和String类间的转化:
缓存机制
只有使用自动装箱时才会使用到缓存里的数据
Integer内部定义了IntegerCache子类,其在static代码块中,随着Integer类的加载而加载,IntegerCache中定义了Integer[]数组,保存了从**-128~127范围的整数。如果我们使用自动装箱**的方式,给Integer赋值的范围在-128~127范围内时,可以直接从该Integer[]数组中获取相应的Integer对象,不用再去new了,因此两次获取到的对象相等。目的:提高效率。
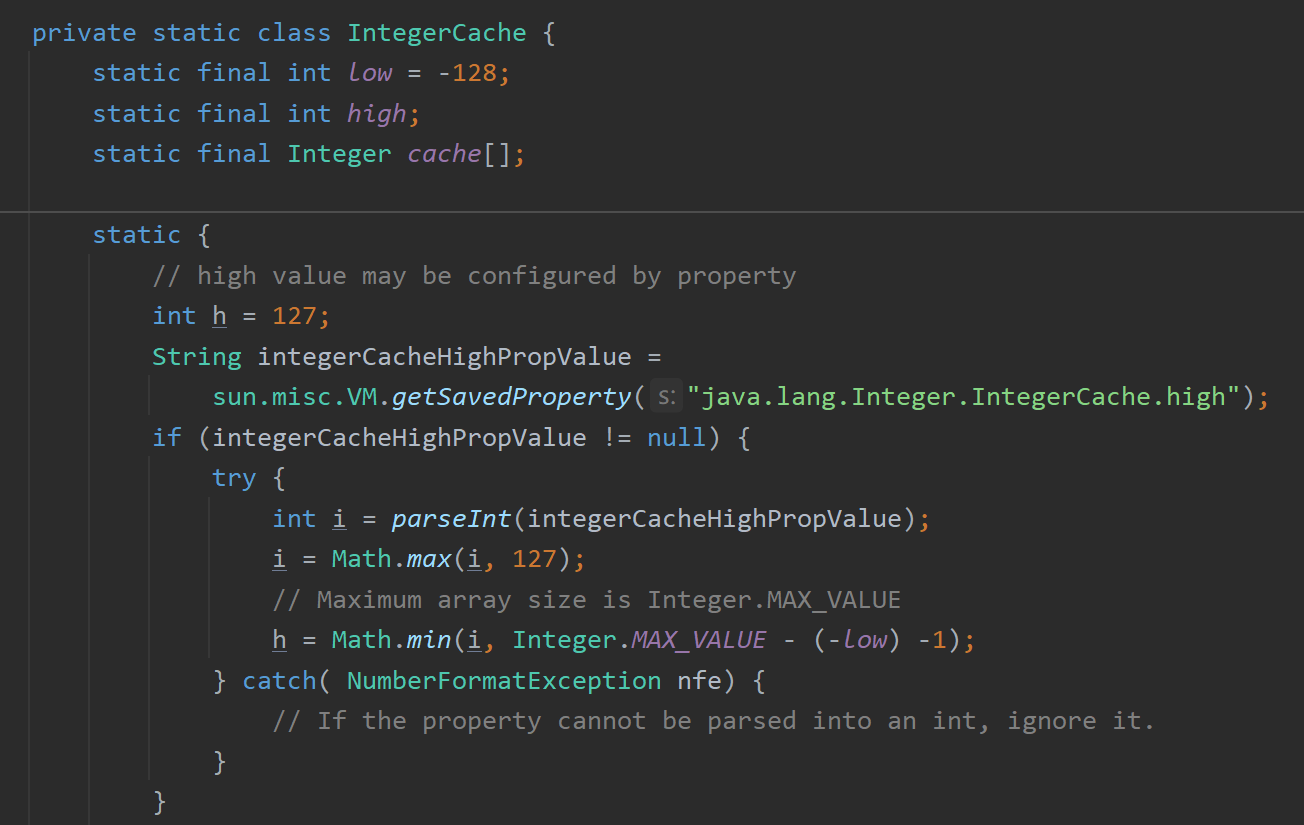
这种缓存机制并不是只有 Integer 才有,同样存在于其他的一些包装类,比如:
- Boolean,缓存了 true/false 对应实例,确切说,只会返回两个常量实例
Boolean.TRUE/FALSE - Short,同样是缓存了 -128 到 127 之间的数值
- Byte,数值有限,所以全部都被缓存
- Character,缓存范围’\u0000’ 到 ‘\u007F’
面试题
1 | public class InterviewTest { |
注意点
- 原则上,建议避免无意中的装箱、拆箱行为,尤其是在性能敏感的场合,创建 10 万个 Java 对象和 10 万个整数的开销可不是一个数量级的,不管是内存使用还是处理速度,光是对象头的空间占用就已经是数量级的差距了。
- 包装类里存储数值的成员变量“value”,不管是 Integer 还 Boolean 等,都被声明为“private final”,所以,它们和 String 一样,都是不可变类型
面向对象
理解 “万事万物皆对象”
- 在Java语言范畴中,我们将功能、结构等封装到类中,通过类的实例,来调用具体的功能结构。
- Scanner、String等
- 文件File等
- 涉及到Java语言与前端html、后端的数据库交互时,前后端的结构在Java层次交互时,都体现为类、对象
方法参数的值传递机制
- 如果变量是基本数据类型,此时赋值的是变量所保存的数据值。
- 如果变量是引用数据类型,此时赋值的是变量所保存的数据的地址值。
1 | public class ValueTransferTest { |
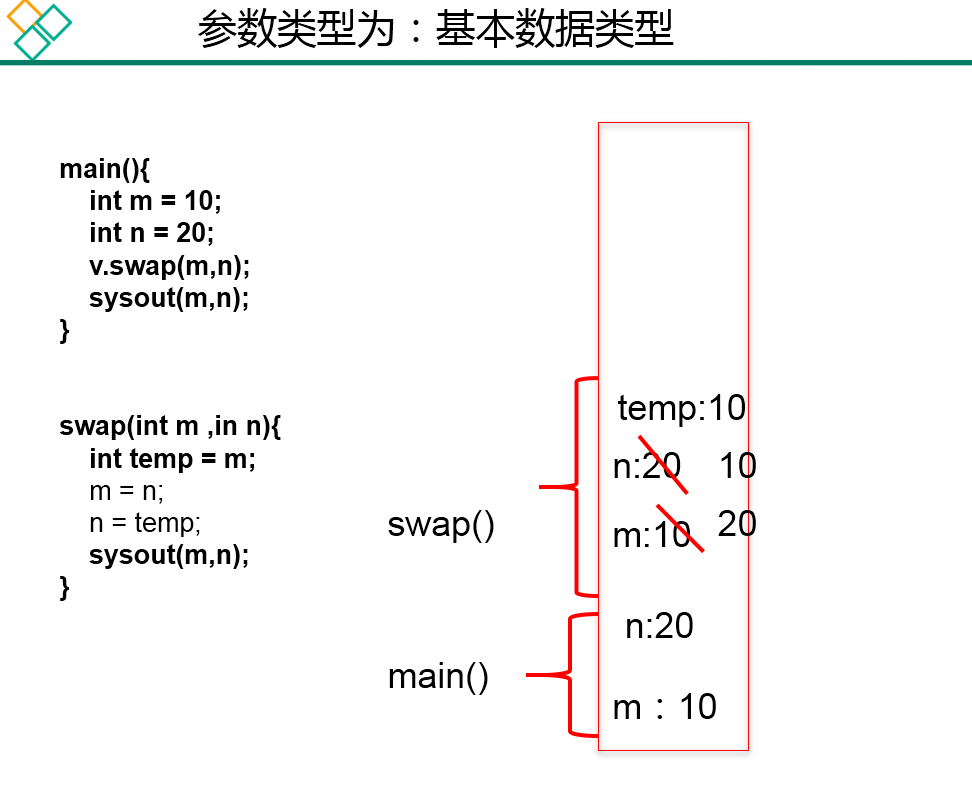
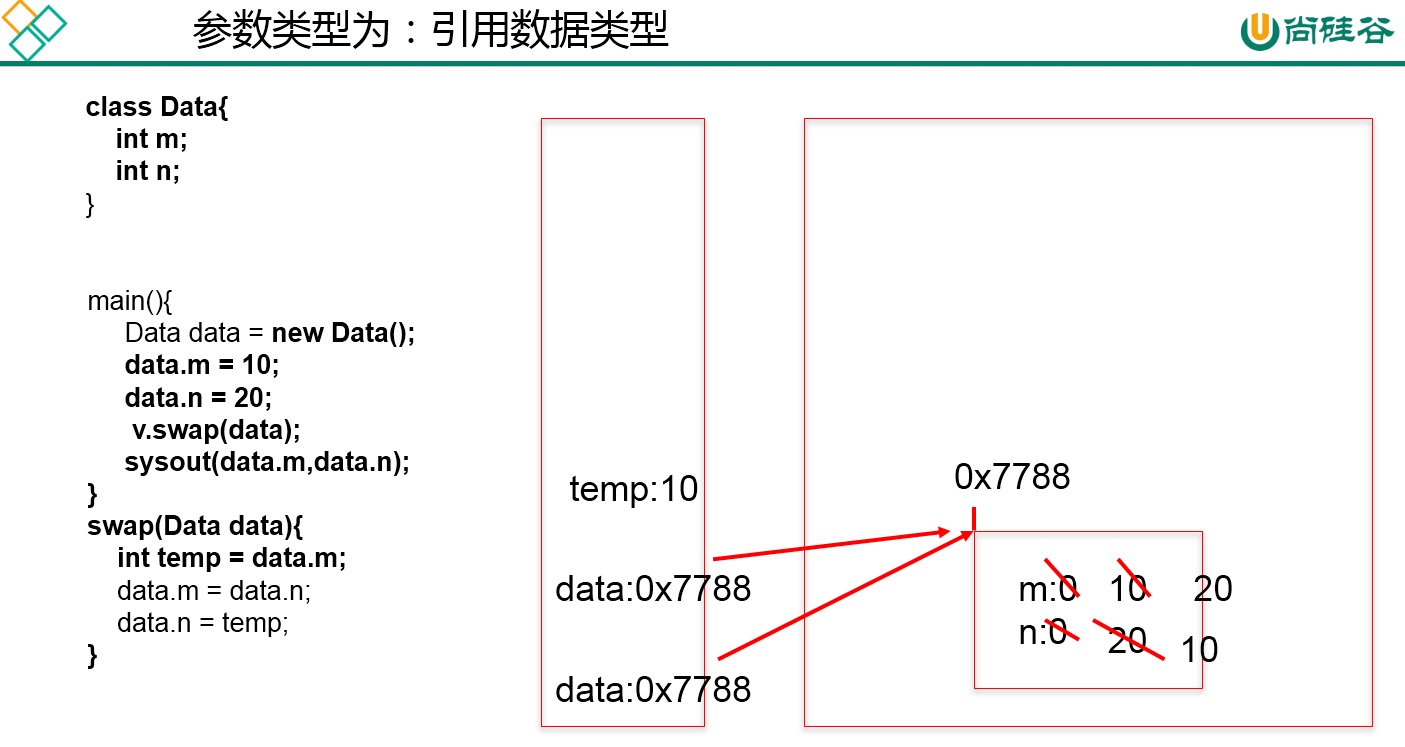
对象的内存解析
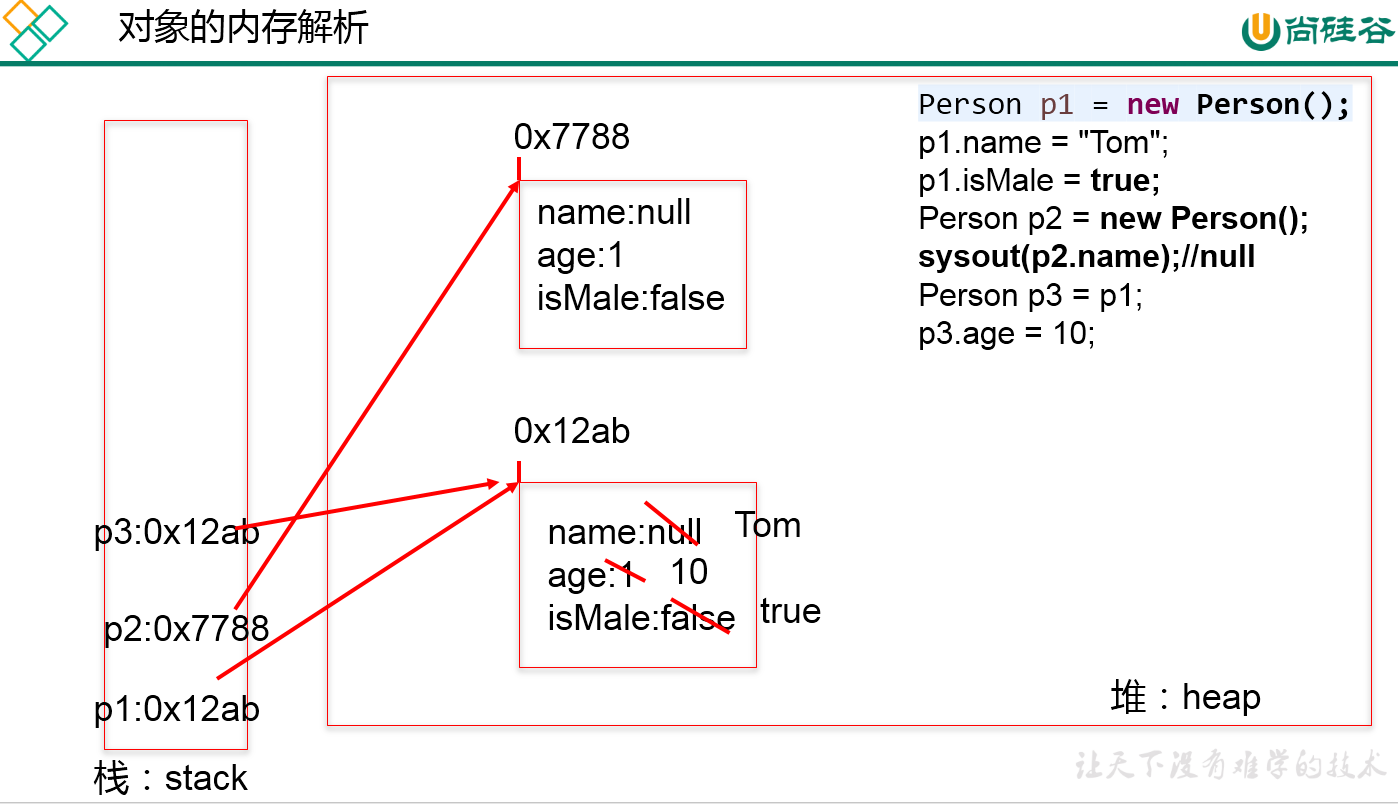
封装性
隐藏对象内部的复杂性,只对外公开简单的接口。便于外界调用,从而提高系统的可扩展性、可维护性。通俗地讲,把该隐藏的隐藏起来,该暴露的暴露出来,这就是封装性的设计思想
程序设计追求“高内聚,低耦合”:
- 高内聚:类的内部数据操作细节自己完成,不允许外部干涉;
- 低耦合 :仅对外暴露少量的方法用于使用 。
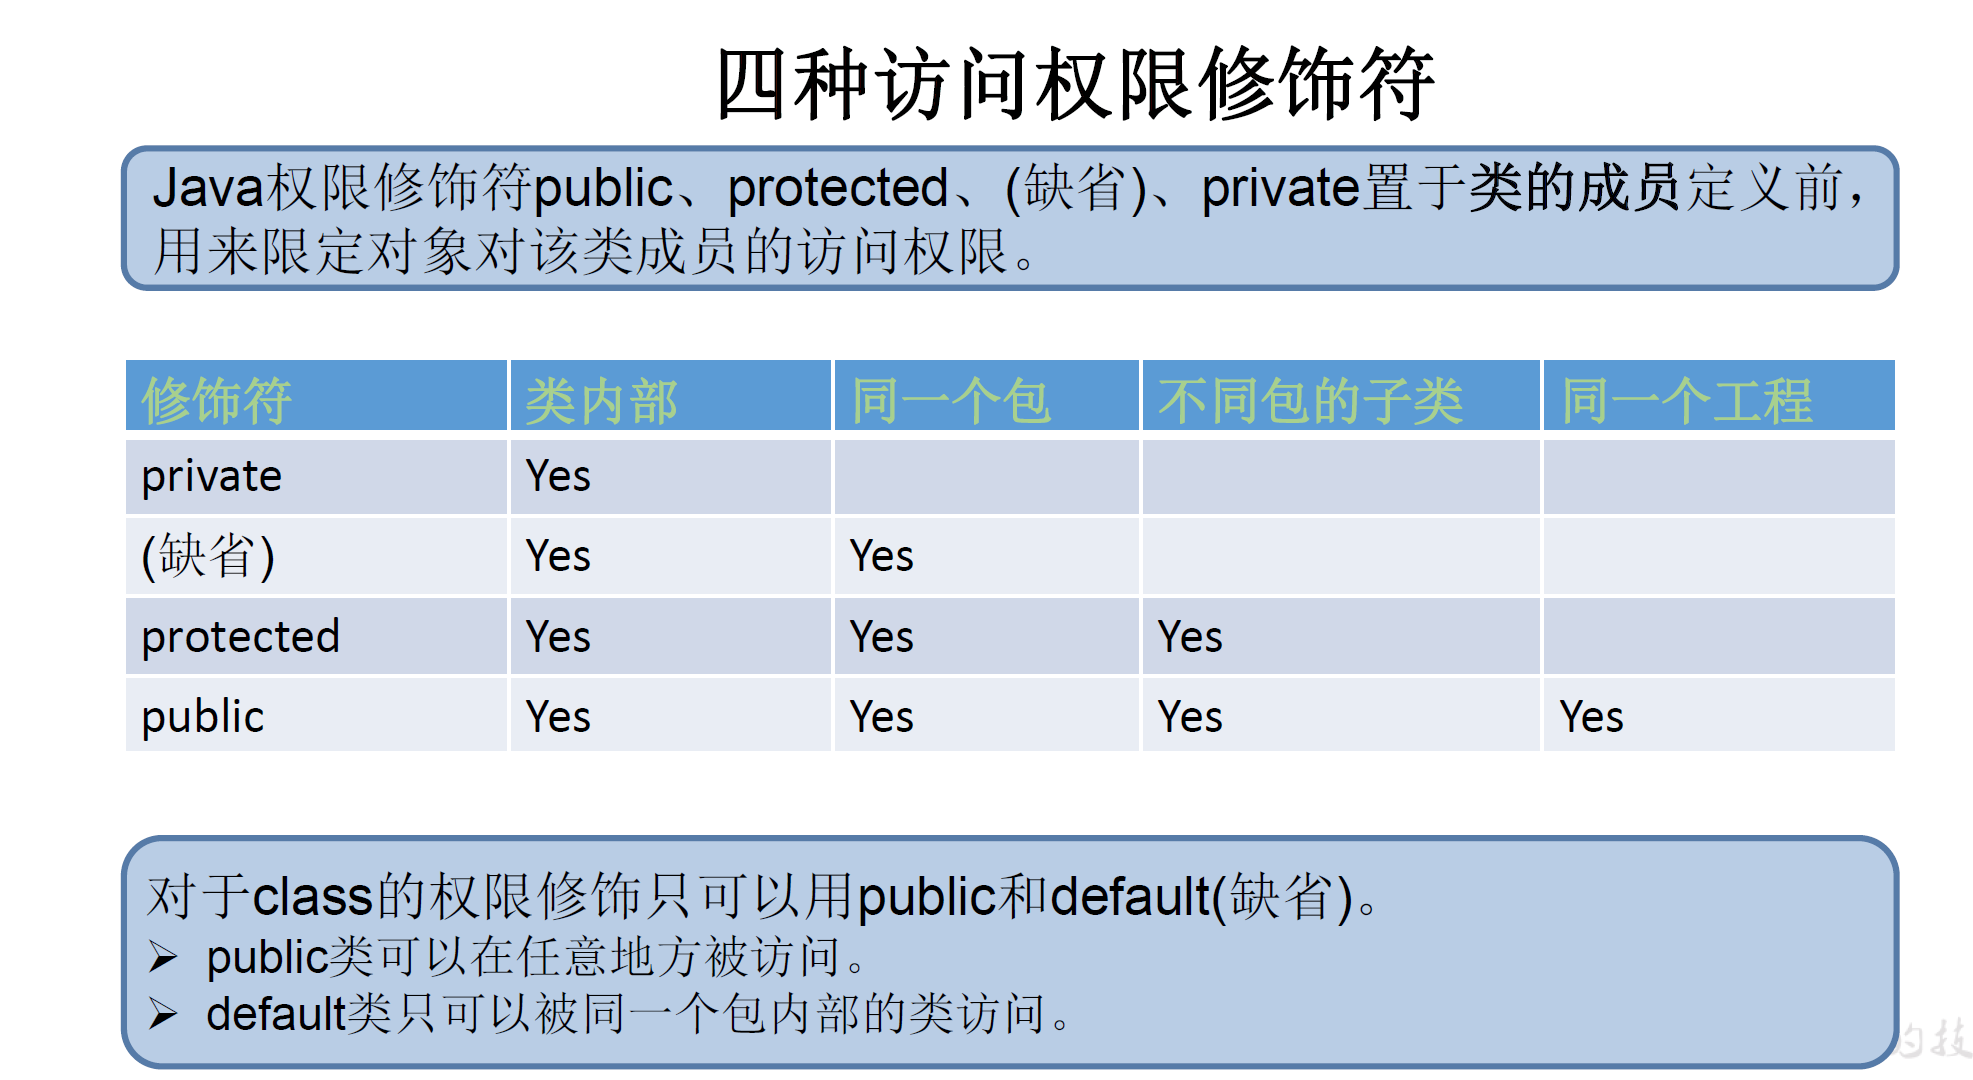
封装性解决结构的可见性问题。其体现在:
- 将属性私有化(
private),避免外界用户通过“对象.属性”的方式获取对象的属性值,提供公共的(public)方法获取(getXxx)和设置(setXxx)该属性的值 - 不对外暴露私有方法
- 单例模式
四种权限修饰符:
继承性
继承性:子类可以继承父类的方法和属性(Java只能单继承,但可以实现多个接口)。继承性的优点:
- 减少了代码的冗余,提高代码的复用性
- 便于功能的扩展
- 为多态性提供了前提
继承性的体现:一旦子类A继承父类B后,子类A就获取了父类B中声明的所有属性和方法。特别的,父类中声明为private的属性或方法,子类继承后,仍然能够拥有。只是因为封装性的影响(封装性将私有属性隐藏起来,不允许其他对象访问),使得子类不能直接调用父类的这些private属性和方法。(只拥有,却不能访问)
继承的特点:
- 一个类可以被多个子类继承。
- Java中类的单继承性:一个类只能有一个父类
- 子父类是相对的概念。
- 子类直接继承的父类,称为:直接父类。间接继承的父类称为:间接父类
- 子类继承父类以后,就获取了直接父类以及所有间接父类中声明的属性和方法
private 修饰的方法虽然可以被子类所继承,但是其没有访问权限,无法破坏其安全性。子类再创建的同名方法就是新方法了
重写(override/overwrite)
定义:在子类中可以根据需要对从父类中继承来的方法进行改造,也称为方法的重置、覆盖。在程序执行时,子类的方法将覆盖父类的方法。
要求:
- 子类重写的方法必须和父类被重写的方法具有相同的方法名称、参数列表
- 子类重写的方法的返回值类型不能大于父类被重写的方法的返回值类型:
- 父类的方法返回类型是引用类型A,子类重写的方法返回值类型可以是A类或者A的子类
- 若父类返回的是基本类型,子类重写的方法返回值类型必须是同样的基本类型
- 子类重写的方法使用的访问权限不能小于父类被重写的方法的访问权限
- 子类不能重写父类中声明为private权限的方法
- 子类方法抛出的异常不能大于父类被重写方法的异常:即子类不能抛出父类所抛出异常的父类异常,因为这不符合继承性和多态性。必须抛出父类所抛出异常的子类异常。
- 父类static修饰的方法子类不能重写(但可以访问)
- 父类static修饰的同名方法子类也必须static修饰
super 关键字
我们可以在子类的方法或构造器中。通过使用"super.属性"或"super.方法"的方式,显式地调用父类中声明的属性或方法。但是,通常情况下,我们习惯省略"super."。特殊情况:
- 当子类和父类中定义了同名的属性时,我们要想在子类中调用父类中声明的属性,则必须显式的使用
"super.属性"的方式,表明调用的是父类中声明的属性。 - 当子类重写了父类中的方法以后,我们想在子类的方法中调用父类中被重写的方法时,则必须显式的使用"super.方法"的方式,表明调用的是父类中被重写的方法。
我们可以在子类的构造器中显式的使用"super(形参列表)"的方式,调用父类中声明的指定的构造器"super(形参列表)"的使用,但必须声明在子类构造器的首行。
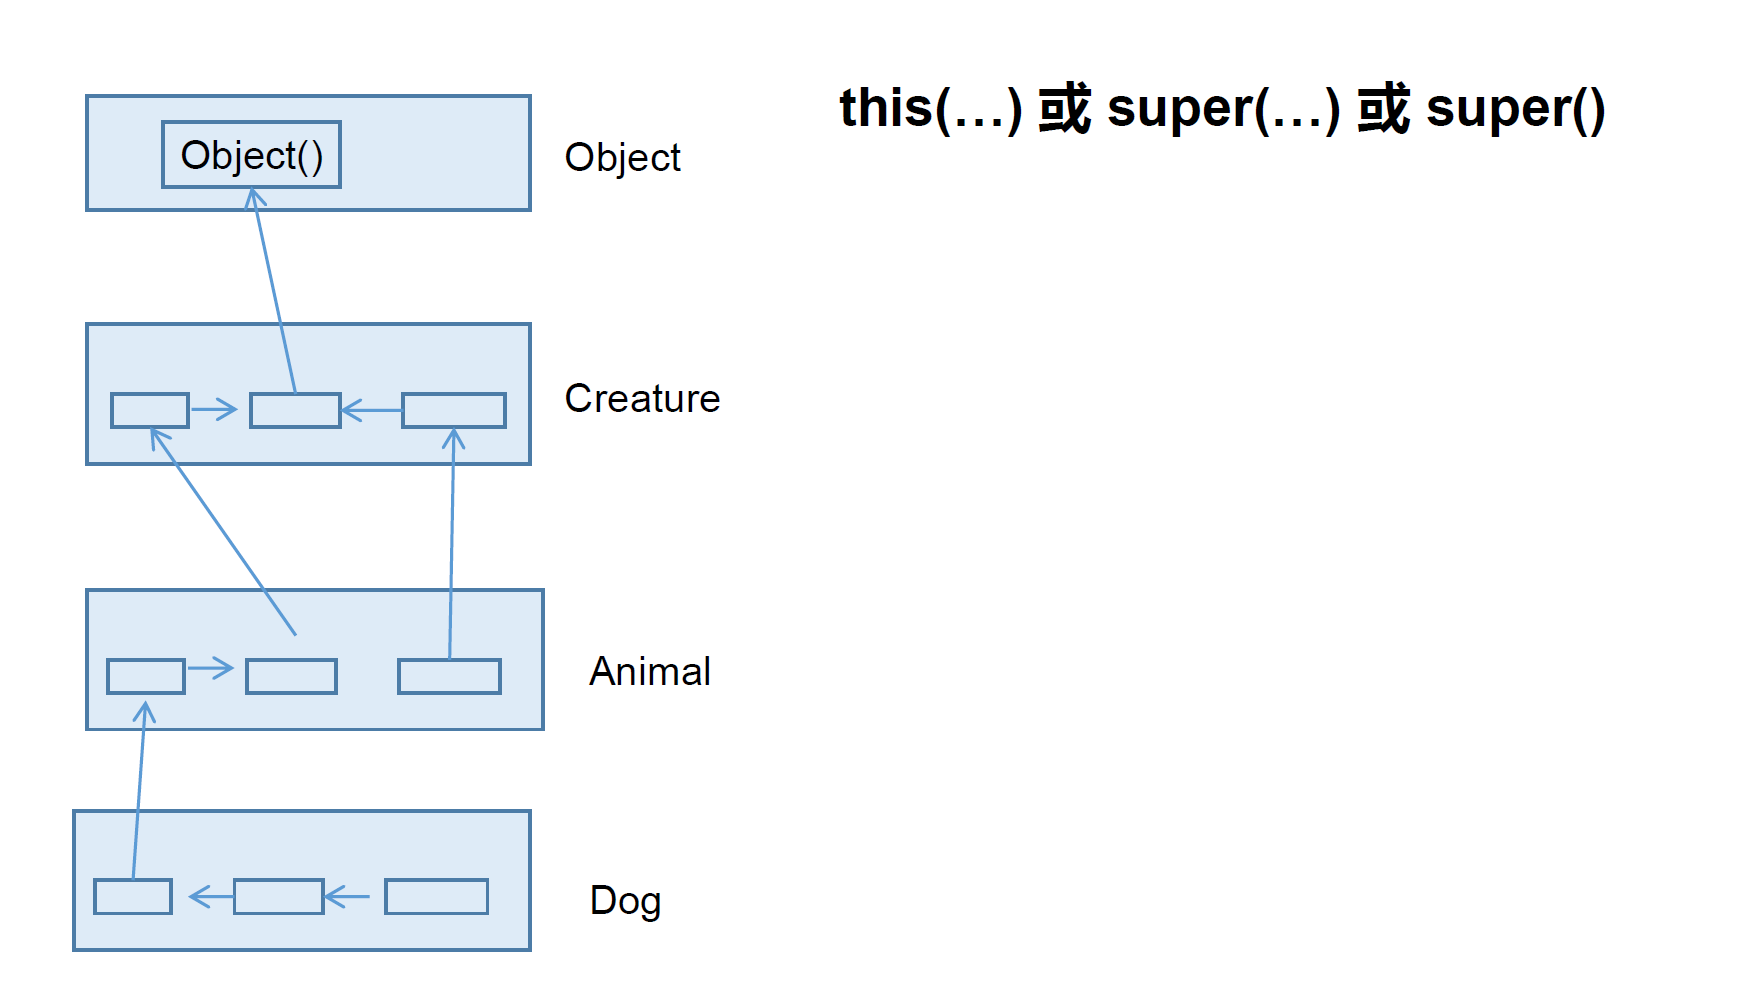
在类的构造器中,针对于"this(形参列表)"或"super(形参列表)"只能二选一,不能同时出现在构造器的首行。没有显式声明"this(形参列表)"或"super(形参列表)",则默认调用的是父类中空参的构造器:super()在类的多个构造器中,至少有一个类的构造器中使用了"super(形参列表)",调用父类中的构造器。
super.()可以忽略不写,缺省情况下调用父类的无参构造器
子类对象实例化的全过程
从结果上来看:(继承性)
- 子类继承父类以后,就获取了父类中声明的全部属性或方法(包括私有)。
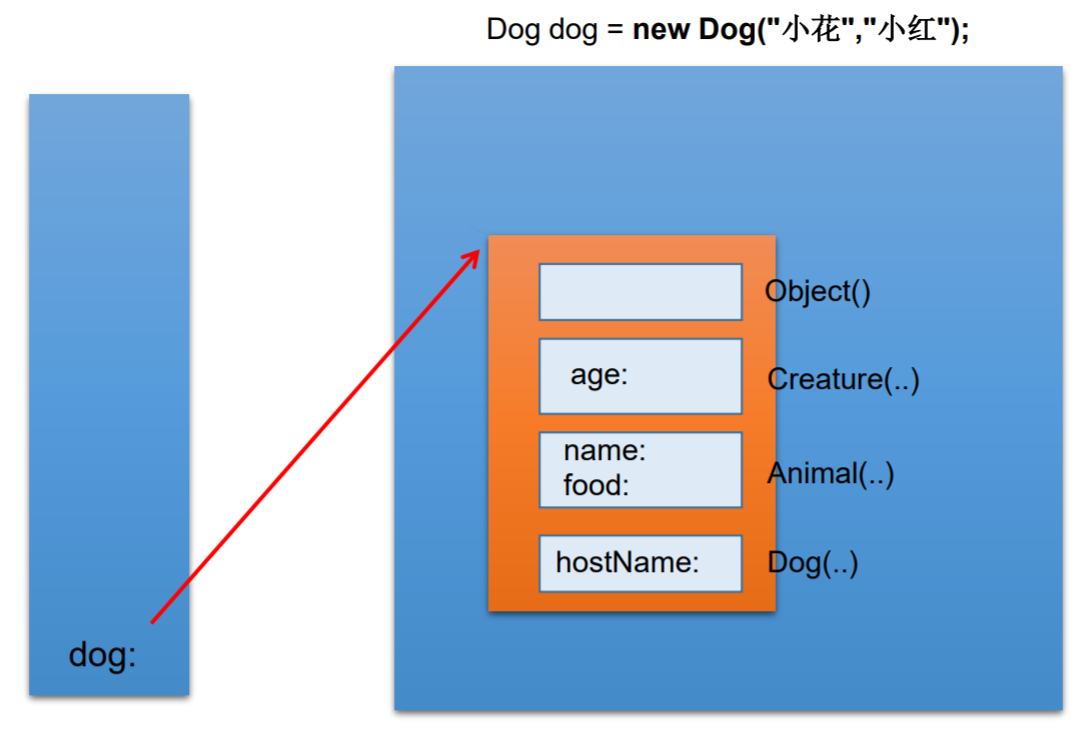
- 创建子类的对象,在堆空间中,就会加载所有父类中声明的属性。
从过程上来看:
- 当我们通过子类的构造器创建子类对象时,我们一定会直接或间接地调用其父类的构造器,进而调用父类的父类的构造器,…
- 直到调用了
java.lang.Object类中空参的构造器为止。正因为加载过所有的父类的结构,所以才可以看到内存中有父类中的结构,子类对象才可以考虑进行调用。
明确:虽然创建子类对象时,调用了父类的构造器,但是自始至终就创建过一个对象,即为new的子类对象。
static 关键字
static可以用来修饰属性、方法、代码块、内部类。static关键字修饰的属性所有对象共享一份数据,修饰的方法可以直接使用类.方法名()的方式使用,其不依赖于类对象,随着类的加载而加载,无需创建类对象即可使用。因为不需要实例就可以访问static方法,因此static方法内部不能有this。(也不能有super )
被修饰后的成员具备以下特点:
- 随着类的加载而加载
- 优先于对象存在
- 修饰的成员,被所有对象所共享
- 访问权限允许时,可不创建对象,直接被类调用
- static修饰的方法不能被重写
类变量 vs 实例变量内存解析:
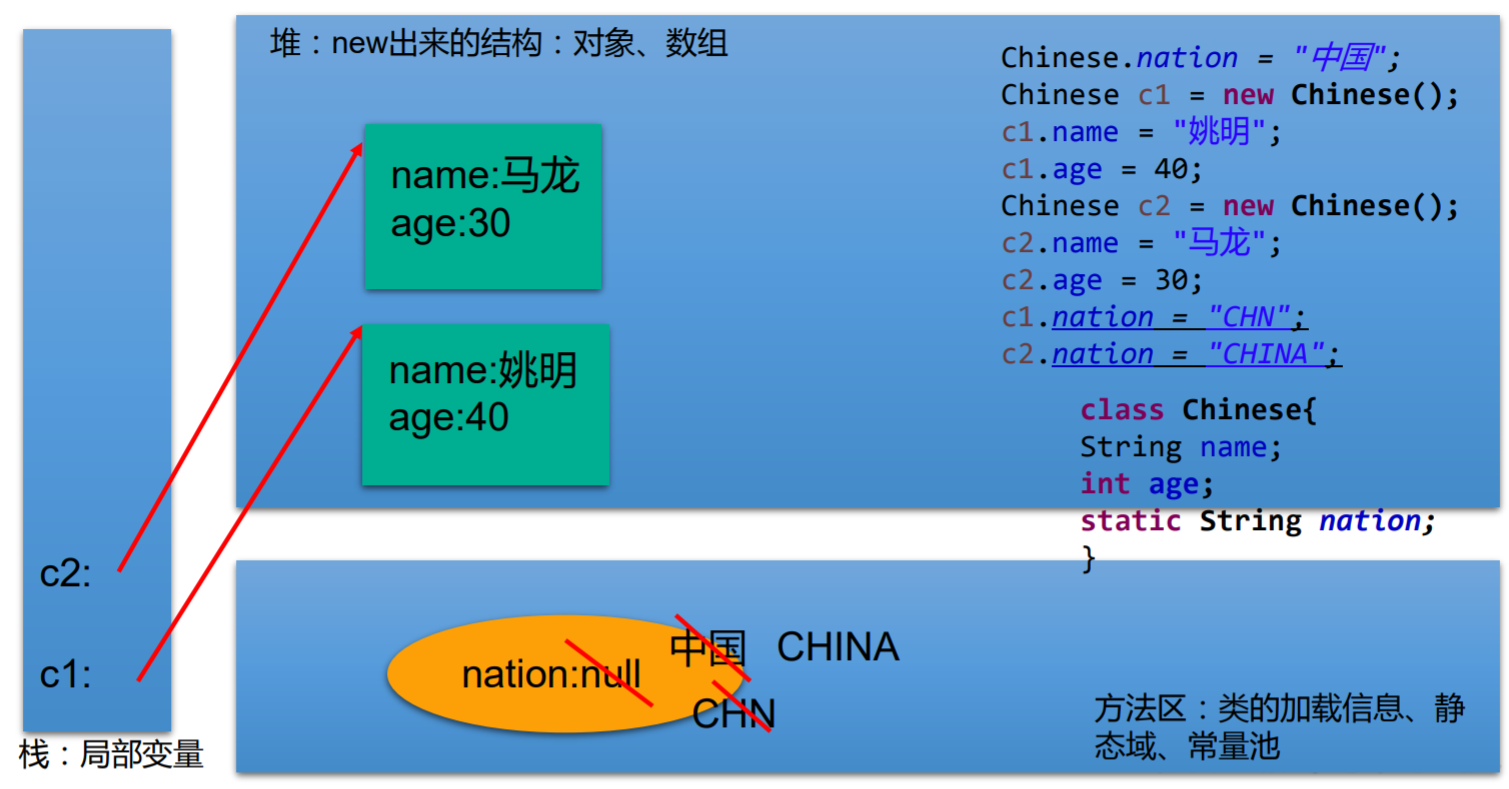
main() 方法
由于Java虚拟机需要调用类的main()方法,所以该方法的访问权限必须是public,又因为Java虚拟机在执行main()方法时不必创建对象,所以该方法必须是static的,该方法接收一个String类型的数组参数,该数组中保存执行Java命令时传递给所运行的类的参数。
又因为main()方法是静态的,我们不能直接访问该类中的非静态成员,必须创建该类的一个实例对象后,才能通过这个对象去访问类中的非静态成员。
代码块
代码块(或初始化块)的作用: 对Java类或对象进行初始化
代码块(或初始化块)的分类:
- 一个类中代码块若有修饰符,则只能被static修饰,称为静态代码块 (static block),没有使用static修饰的,为非静态代码块。
- static代码块通常用于初始化static的属性
1 | class Person { |
静态代码块:用static修饰的代码块
- 可以有输出语句。
- 可以对类的属性、类的声明进行初始化操作。
- 不可以对非静态的属性初始化。即:不可以调用非静态的属性和方法。
- 若有多个静态的代码块,那么按照从上到下的顺序依次执行。
- 静态代码块的执行要先于非静态代码块。
- 静态代码块随着类的加载而加载,且只执行一次。
**非静态代码块:没有static修饰的代码块 **
- 可以有输出语句。
- 可以对类的属性、类的声明进行初始化操作。
- 除了调用非静态的结构外,还可以调用静态的变量或方法。
- 若有多个非静态的代码块,那么按照从上到下的顺序依次执行。
- 每次创建对象的时候,都会执行一次。且先于构造器执行。
程序中成员变量赋值的执行顺序:
- 默认初始化(类加载到虚拟机中就会先为每个属性值赋初始值
- 显式初始化(
int i = 3) 或 在代码块中赋值({ i = 3})。此时的顺序看二者谁先写谁后写 - 在构造器中初始化
- 有了对象后,通过"对象.属性"等方法赋值
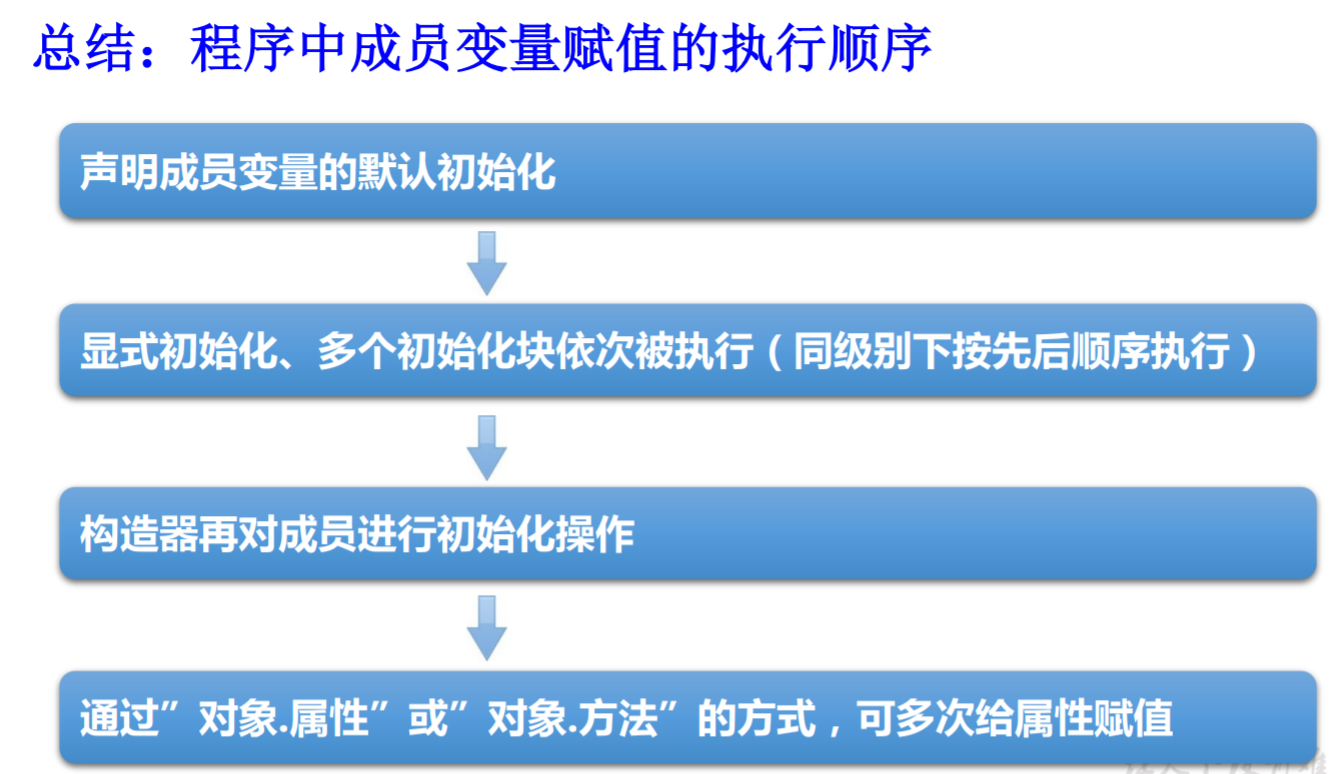
多态
对象的多态性:父类的引用指向子类的对象,可以直接应用在抽象类和接口上。
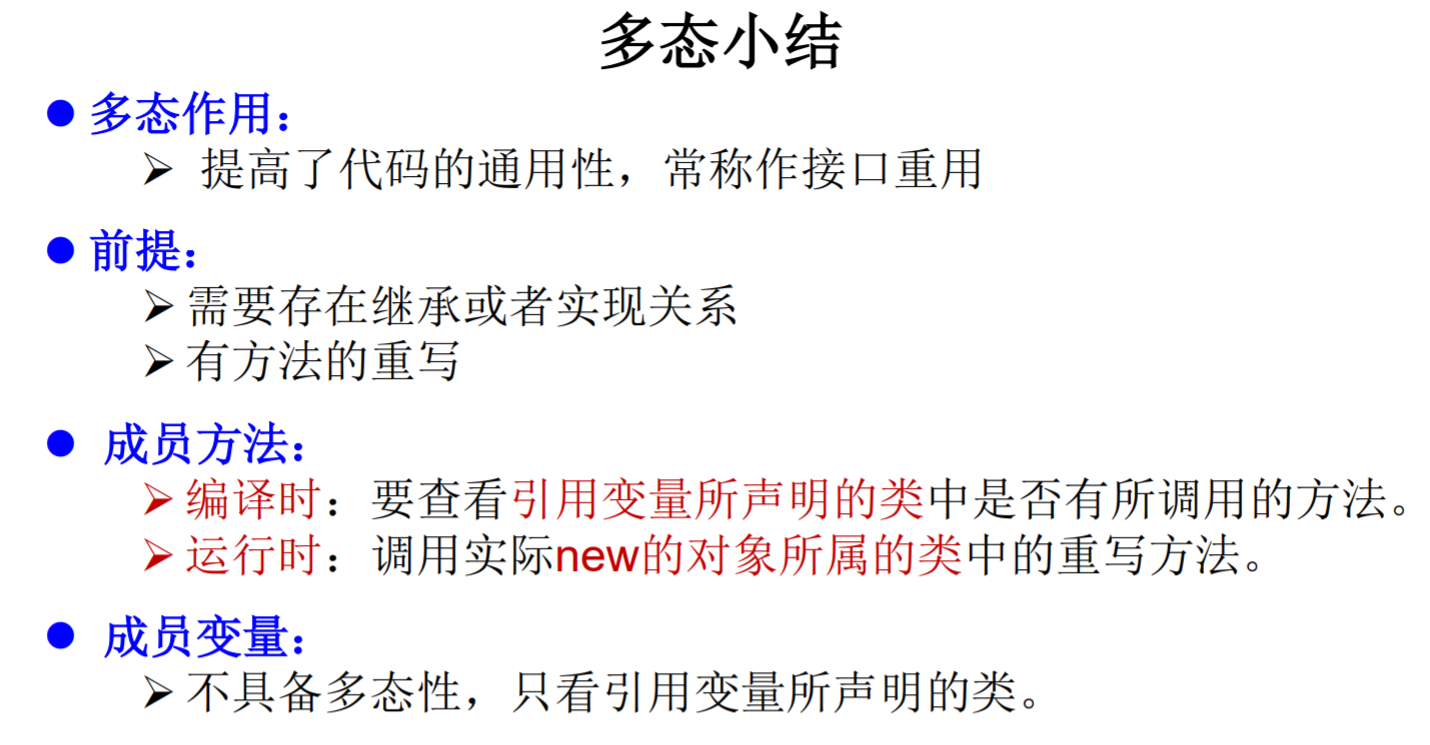
Java引用变量有两个类型:编译时类型和运行时类型。编译时类型由声明该变量时使用的类型决定,运行时类型由实际赋给该变量的对象决定。简称:编译时,看左边;运行时,看右边。若编译时类型和运行时类型不一致,就出现了对象的多态性(Polymorphism)。多态情况下:
- “看左边” :看的是父类的引用(父类中不具备子类特有的方法和属性)
- “看右边” :看的是子类的对象(实际运行的是子类重写父类的方法)
属性不遵循多态性,直接对象.属性得到的是父类里的属性值,无法获得子类的属性值。
一个引用类型变量如果声明为父类的类型,但实际引用的是子类对象,那么该变量就不能再访问子类中独有的属性和方法,只能访问父类的属性和方法。若仍想使用子类独有的属性和方法,则需要向下转型。
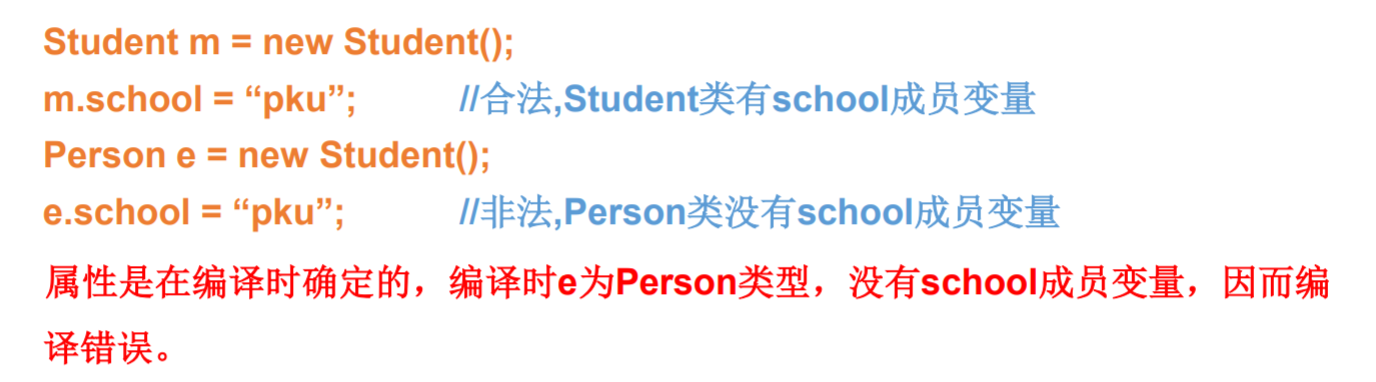
内存空间分析:如下代码中,在new Student() 时,会在堆空间中创建出该对象的所有属性和方法,在栈空间中创建一个Person类型的引用变量,存储堆中Student对象的地址值。之后可以通过p.方法()的方式获取到Student类所重写的方法,但却无法访问到Student所独有的属性和方法(这些属性虽然已经加载在了堆空间中,但却无法被p对象所访问,因为编译时期编译器判断p对象所属的Person类并没有这些属性和方法,因此编译不通过),只有使用向下转型后p对象才能访问到这些独有的属性。p对象可以获取到Person类拥有的属性值。
关键原因还在于编译器在编译时期判断当前对象p是否有这些属性和方法,有的就可以调用,没有的就不能调用(只能使用向下转型后变成子类类型对象,编译器才能通过)。
1 | Person p = new Student(); |
虚拟方法调用
子类中定义了与父类同名同参数的方法,在多态情况下,将此时父类的方法称为虚拟方法(类比C++中的虚函数)。简单理解:编译时使用该方法是虚拟的,运行时还是调用子类的方法。
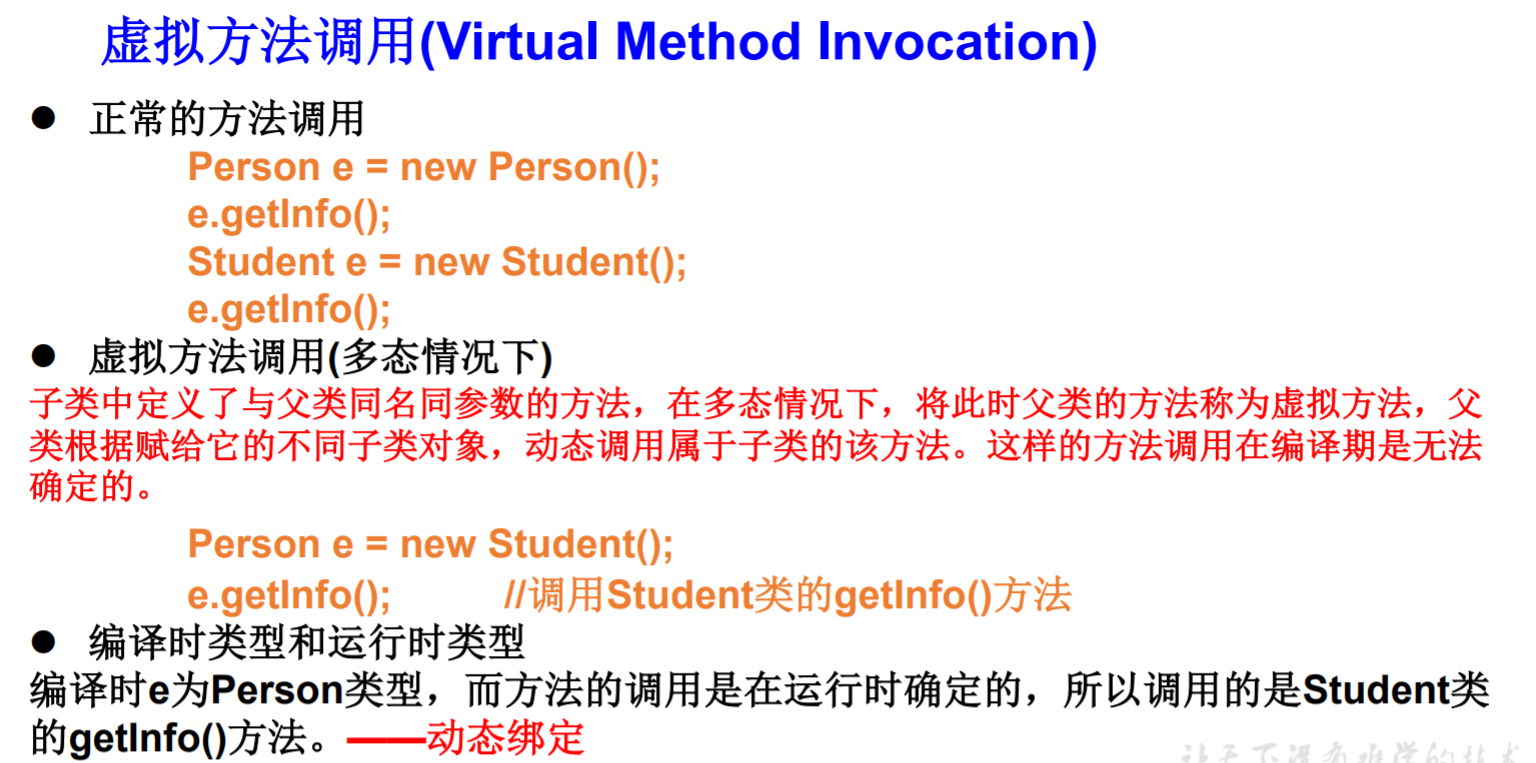
对象类型转换
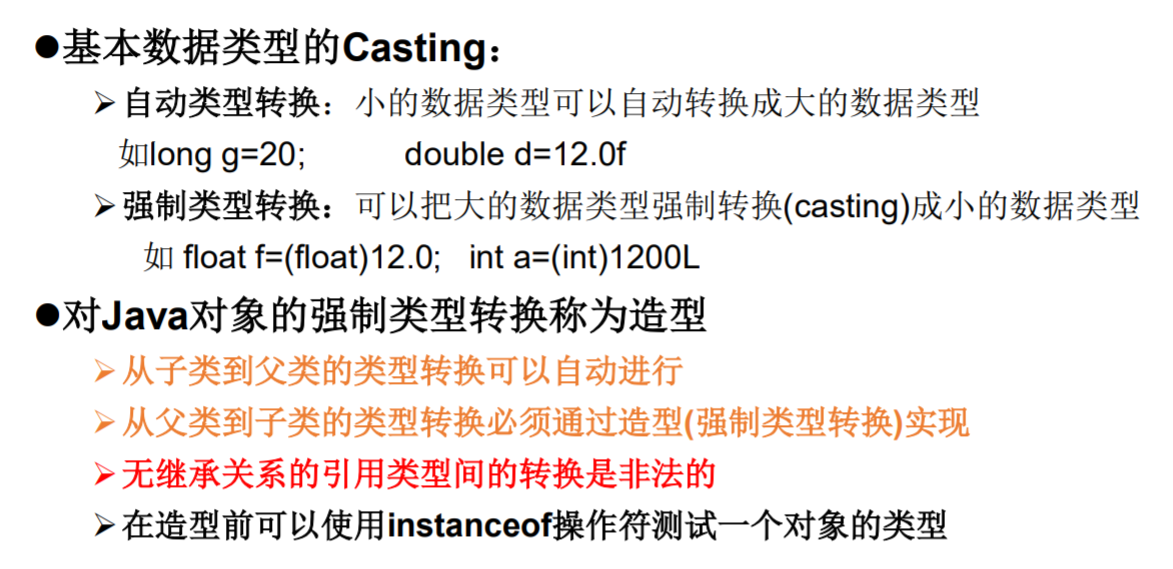
向上转型
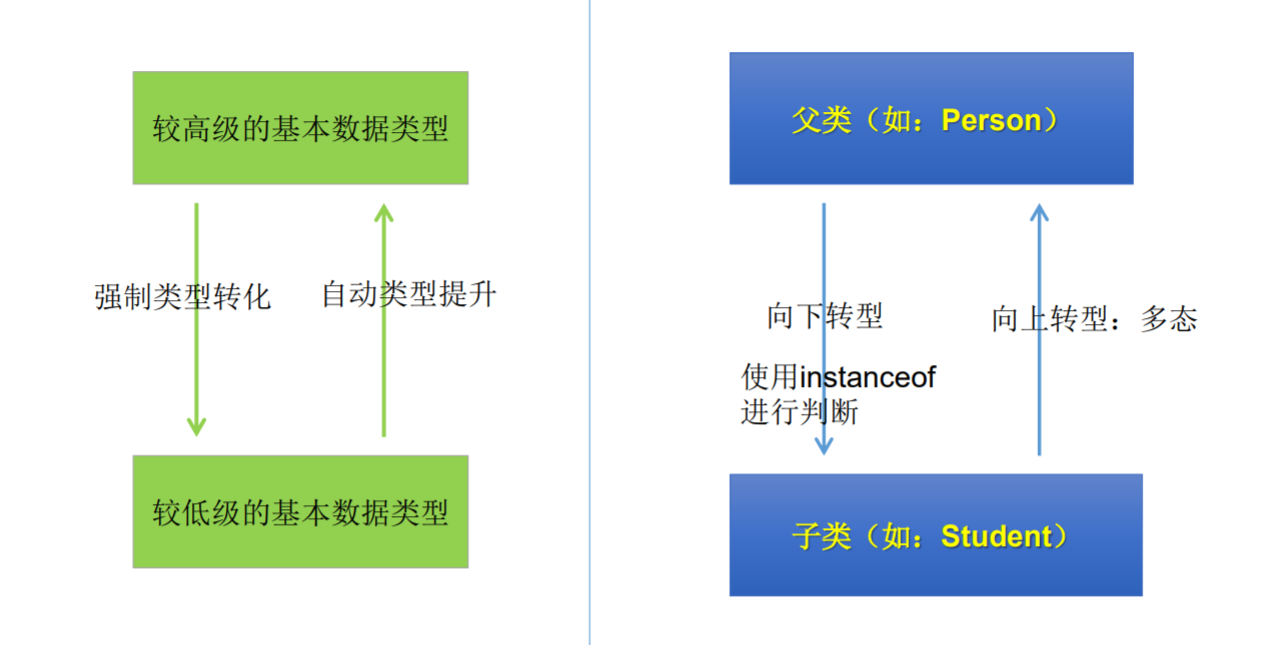
向上转型:多态的体现。将指向子类的父类引用对象向上转型为指向父类,该过程可以自动进行,就如同小的基本数据类型可以自动转换为大的数据类型,没有任何问题。
1 | Person p = new Student(); |
向下转型
向下转型:父类引用类型对象原本无法使用所指向的子类独有的属性和方法,若想使用,则需要q强制类型转换。即从父类引用类型对象转换为子类引用类型对象(无继承关系的引用类型间的转换是非法的,在转型前可以使用instanceof操作符测试一个对象的类型是否有继承关系)。就如同大的基本数据类型向小的基本数据类型转换需要使用强制类型转换。
1 | Person p = new Student(); |
重写与重载的区别
从编译和运行的角度看: 重载,是指允许存在多个同名方法,而这些方法的参数不同。编译器根据方法不同的参数表,对同名方法的名称做修饰。对于编译器而言,这些同名方法就成了不同的方法。它们的调用地址在编译期就绑定了。Java的重载是可以包括父类和子类的,即子类可以重载父类的同名不同参数的方法。所以:对于重载而言,在方法调用之前,编译器就已经确定了所要调用的方法,这称为“早绑定”或“静态绑定”;
而对于多态,只有等到方法调用的那一刻,解释运行器才会确定所要调用的具体方法,这称为 “晚绑定”或“动态绑定”。
Bruce Eckel:“不要犯傻,如果它不是晚绑定,它就不是多态。”
谈谈你对多态性的理解?
- 实现代码的通用性。
Object类中定义的public boolean equals(Object obj){ }- JDBC:使用java程序操作(获取数据库连接、CRUD)数据库(MySQL、Oracle、DB2、SQL Server)
- 抽象类、接口的使用体现了多态性。(因为抽象类、接口不能实例化,需要通过多态性创建指向子类的对象)
多态性小结
多态性练习
若子类重写了父类方法,就意味着子类里定义的方法彻底覆盖了父类里的同名方法, 系统将不可能把父类里的方法转移到子类中:编译看左边,运行看右边
对于属性变量则不存在这样的现象,即使子类里定义了与父类完全相同的属性变量,这个属性变量依然不可能覆盖父类中定义的属性变量:编译运行都看左边
1 | class Base { |
== 与 equals()
== 运算符
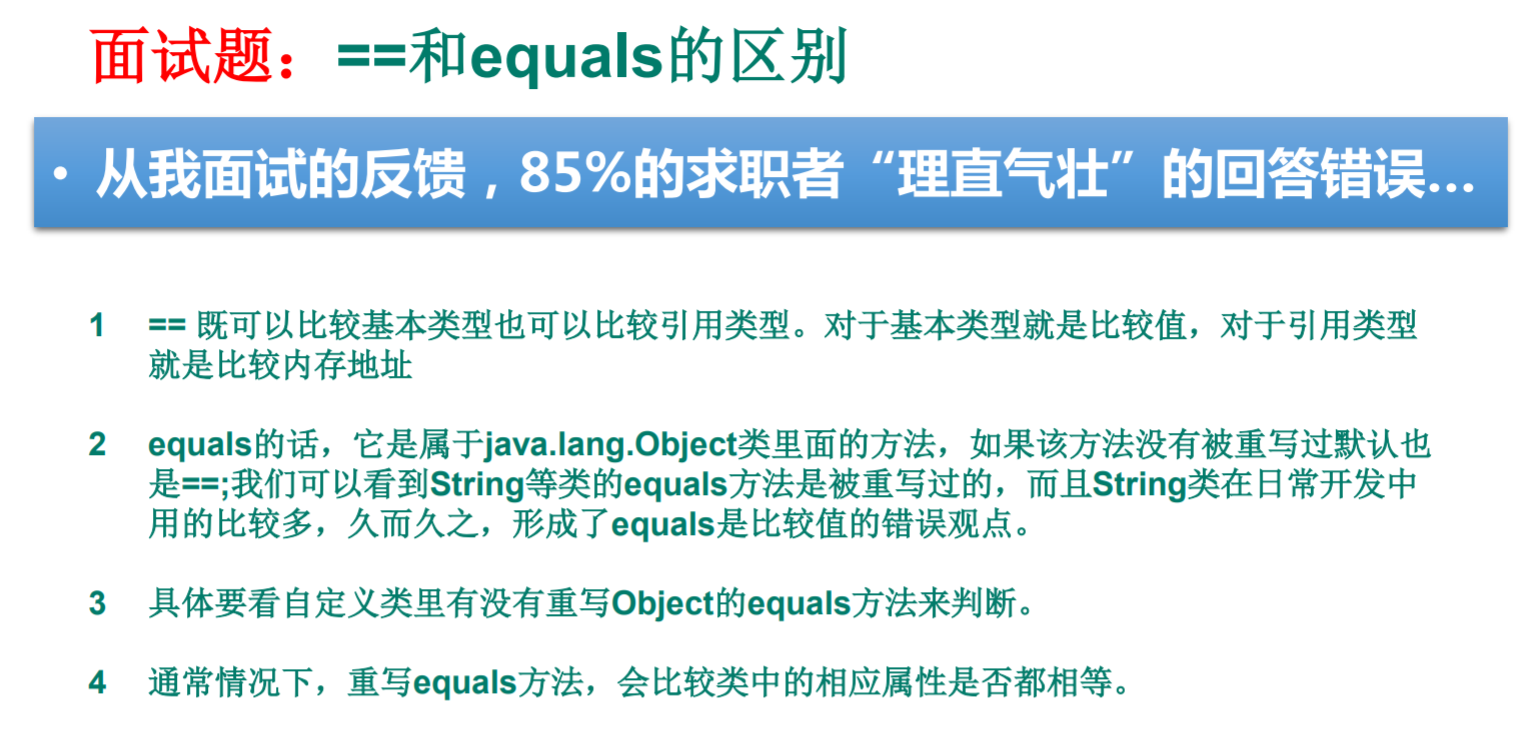
== :运算符。可以使用在基本数据类型变量和引用数据类型变量中。
- 如果比较的是基本数据类型变量:比较两个变量保存的数据是否相等。(不一定类型要相同,int和double类型的变量也能比较)
- 如果比较的是引用数据类型变量:比较两个对象的地址值是否相同。即两个引用是否指向同一个对象实体
补充: == 符号使用时,必须保证符号左右两边的变量类型一致。
equals()
equals()方法的使用:
- 是一个方法,而非运算符
- 只能适用于引用数据类型
Object类中equals()的定义:
1 | public boolean equals(Object obj) { |
说明:Object类中定义的equals()和==的作用是相同的:比较两个对象的地址值是否相同。即两个引用是否指向同一个对象实体
像String、Date、File、包装类等都重写了Object类中的equals()方法。重写以后,比较的不是两个引用的地址是否相同,而是比较两个对象的"实体内容"是否相同。
通常情况下,我们自定义的类如果使用equals()的话,也通常是比较两个对象的"实体内容"是否相同。那么,我们就需要对Object类中的equals()进行重写。重写的原则:比较两个对象的实体内容是否相同。
1 | public class EqualsTest { |
final
final 可以用来修饰:类、方法、变量。
- final 用来修饰类:此类不能被其他类所继承。比如:
String类、System类、StringBuffer类 - final 用来修饰方法:表明此方法不可以被重写。比如:
Object类中getClass(); - final 用来修饰变量:此时的"变量"就称为是一个常量
- final修饰属性:可以考虑赋值的位置:显式初始化、代码块中初始化、构造器中初始化
- final修饰局部变量:尤其是使用final修饰形参时,表明此形参是一个常量。当我们调用此方法时,给常量形参赋一个实参。一旦赋值以后,就只能在方法体内使用此形参,但不能进行重新赋值。
使用
final修饰想要保证线程安全性的方法,这样子类就无法重写该方法,无法破坏其安全性
static final 用来修饰的属性:全局常量
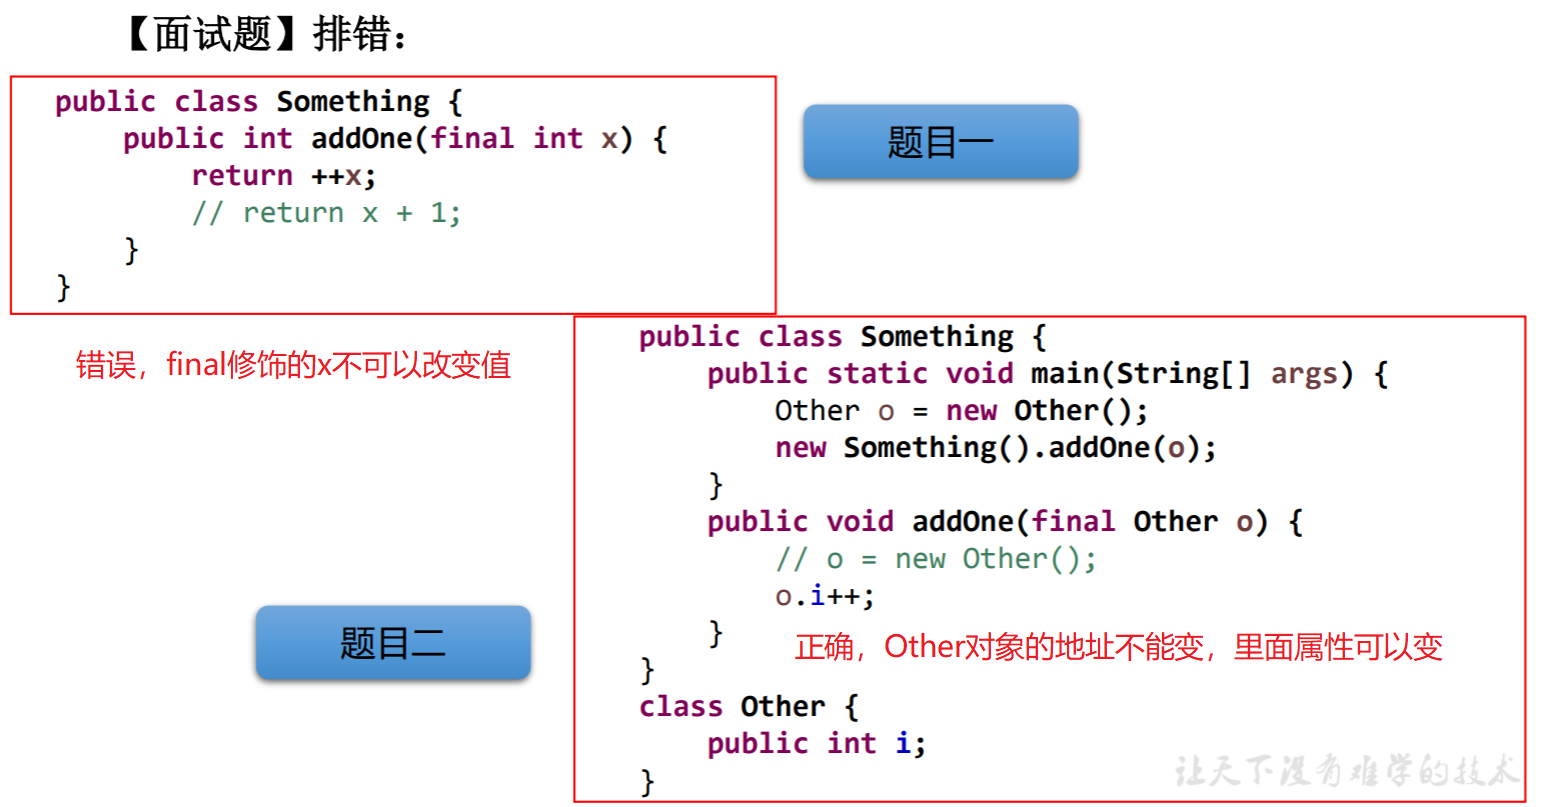
final、finally、 finalize 区别
- final 可以用来修饰类、方法、变量,分别有不同的意义:
- final 修饰的 class 代表不可以继承扩展
- final 的变量是不可以修改的
- final 的方法也是不可以重写的(override)
- finally 则是 Java 保证重点代码一定要被执行的一种机制。我们可以使用 try-finally 或者 try-catch-finally 来进行类似关闭 JDBC 连接、保证 unlock 锁等动作
- finalize 是基础类
java.lang.Object的一个方法,它的设计目的是保证对象在被垃圾收集前完成特定资源的回收。finalize 机制现在已经不推荐使用,并且在 JDK 9 开始被标记为 deprecated
abstract
可以用来修饰:类、方法。
abstract修饰类:抽象类
- 此类不能实例化
- 抽象类中一定有构造器,便于子类实例化时调用(涉及:子类对象实例化的全过程)
- 开发中,都会提供抽象类的子类,让子类对象实例化,完成相关的操作 —> 抽象的使用前提:继承性
abstract修饰方法:抽象方法
- 抽象方法只有方法的声明,没方法体
- 包含抽象方法的类,一定是一个抽象类。反之,抽象类中可以没有抽象方法的。
- 若子类重写了父类中的所的抽象方法后,此子类方可实例化
- 若子类没重写父类中的所的抽象方法,则此子类也是一个抽象类,需要使用
abstract修饰
注意点:
- abstract不能用来修饰:属性、构造器等结构
- abstract不能用来修饰私方法、静态方法、final的方法、final的类
interface
Java中,接口和类是并列的两个结构。接口中不能定义构造器的!意味着接口不可以实例化。
**接口也可以 new。**但是需要以匿名内部类的形式 new,同时实现其方法。(例如Lambda表达式)
如何定义接口:定义接口中的成员,JDK7及以前:只能定义全局常量和抽象方法。JDK8:除了定义全局常量和抽象方法之外,还可以定义静态方法、默认方法。
- 全局常量:
public static final的。书写时,可以省略不写 - 抽象方法:
public abstract的
Java开发中,接口通过让类去实现(implements)的方式来使用。
- 如果实现类覆盖了接口中的所有抽象方法,则此实现类就可以实例化
- 如果实现类没覆盖接口中所有的抽象方法,则此实现类仍为一个抽象类
Java类可以实现多个接口—> 弥补了Java单继承性的局限性。格式:class AA extends BB implements CC,DD,EE
接口与接口之间可以继承,而且可以多继承。接口的具体使用,体现多态性。接口,实际上可以看做是一种规范。
Java 8 中关于接口的新规范
- 知识点1:接口中定义的静态方法,只能通过接口来调用。
- 知识点2:通过实现类的对象,可以调用接口中的默认方法。如果实现类重写了接口中的默认方法,调用时,仍然调用的是重写以后的方法。
- 知识点3:如果子类(或实现类)继承的父类和实现的接口中声明了同名同参数的默认方法,那么子类在没重写此方法的情况下,默认调用的是父类中的同名同参数的方法。–> 类优先原则
- 知识点4:如果实现类实现了多个接口,而这多个接口中定义了同名同参数的默认方法,那么在实现类没重写此方法的情况下,报错。–> 接口冲突。这就需要我们必须在实现类中重写此方法。
- 知识点5:如何在子类(或实现类)的方法中调用父类、接口中被重写的方法
抽象类和接口的异同
- 相同点:都不能实例化;都可以包含抽象方法的。
- 不同点:
- 把抽象类和接口(java7,java8,java9)的定义、内部结构解释说明
- 抽象类里可以没有抽象方法,但接口里都是抽象方法(Java 8之后可以定义默认方法)
- 抽象类中必须定义构造器,接口中不能定义构造器
- 类:单继承性,接口:多继承
- 类与接口:多实现
异常
运行时异常:
- 是指编译器不要求强制处置的异常。一般是指编程时的逻辑错误,是程序员应该积极避免其出现的异常。
java.lang.RuntimeException类及它的子类都是运行时异常。 - 对于这类异常,可以不作处理,因为这类异常很普遍,若全处理可能会对程序的可读性和运行效率产生影响。
编译时异常:
- 是指编译器要求必须处置的异常。即程序在运行时由于外界因素造成的一般性异常。编译器要求Java程序必须捕获或声明所有编译时异常。
- 对于这类异常,如果程序不处理,可能会带来意想不到的结果。
常见异常
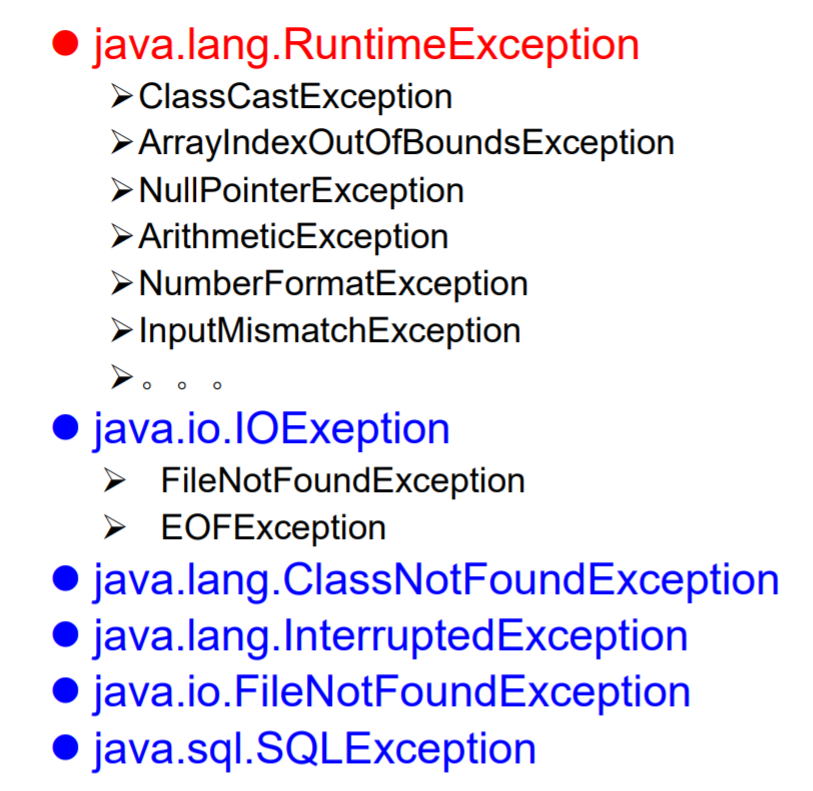
常见异常:
- 空指针异常:
NullPointerException - 数学运算异常:
ArithmetricException - IO异常:
IOException,例如FileNotFoundException - 数组越界异常:
ArrayIndexOutOfBoundsException - 线程中断异常:
InterruptedException(线程被外部其他线程打断时抛出)
补充一些高级异常:
- 并发修改异常:
ConcurrentModificationException(fail-fast机制:HashMap与LinkedList等类型在迭代过程中被其他线程并发修改集合结构时会抛出该异常,使得迭代停止) - 非法监控器状态异常:
IllegalMonitorStateException(解锁的线程和占有锁的线程不同时会抛出) - 栈溢出异常:
StackOverflowError - 内存溢出异常:
OutOfMemoryError - 微服务远程调用超时异常:
feign.RetryableException: Read timed out executing POST http://xxx(常出现在 DEBUG 模式下远程调用微服务超时)
编译时异常与运行时异常:
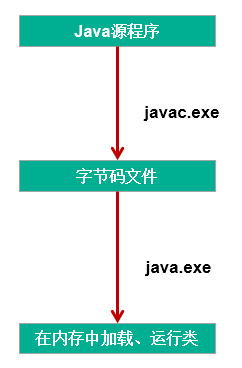
- 编译时异常:执行
javac.exe命名时,可能出现的异常 - 运行时异常:执行
java.exe命名时,出现的异常
异常体系结构
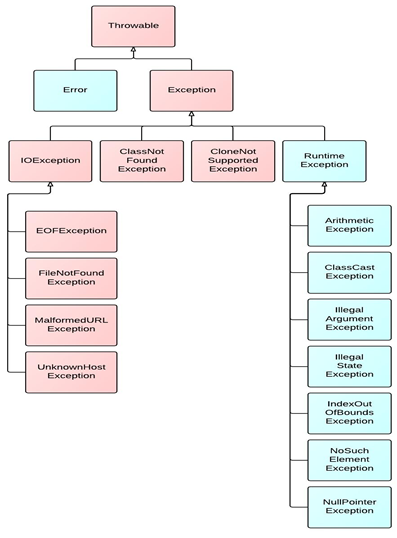
检查异常 Checked Exception,在源代码里必须显式地进行捕获处理,这是编译期检查的一部分。不检查异常(运行时异常),只在运行时才可能抛出(除了 RuntimeException 与其子类,以及错误(Error),其他的都是检查异常(绝对的大家族)
Exception 和 Error 的区别:
- Exception 和 Error 都是继承了 Throwable 类,在 Java 中只有 Throwable 类型的实例才可以被抛出(throw)或者捕获(catch),它是异常处理机制的基本组成类型。
- Exception 和 Error 体现了 Java 平台设计者对不同异常情况的分类。
- Exception 是程序正常运行中,可以预料的意外情况,可能并且应该被捕获,进行相应处理。
- Error 是指在正常情况下,不大可能出现的情况,绝大部分的 Error 都会导致程序(比如 JVM 自身)处于非正常的、不可恢复状态。既然是非正常情况,所以不便于也不需要捕获,常见的比如
OutOfMemoryError之类,都是 Error 的子类。
- Exception 又分为可检查(checked)异常和不检查(unchecked)异常,
- 可检查异常在源代码里必须显式地进行捕获处理,这是编译期检查的一部分。
- 不检查异常就是所谓的运行时异常,类似
NullPointerException、ArrayIndexOutOfBoundsException之类,通常是可以编码避免的逻辑错误,具体根据需要来判断是否需要捕获,并不会在编译期强制要求。不检查的 Error,是 Throwable 不是 Exception
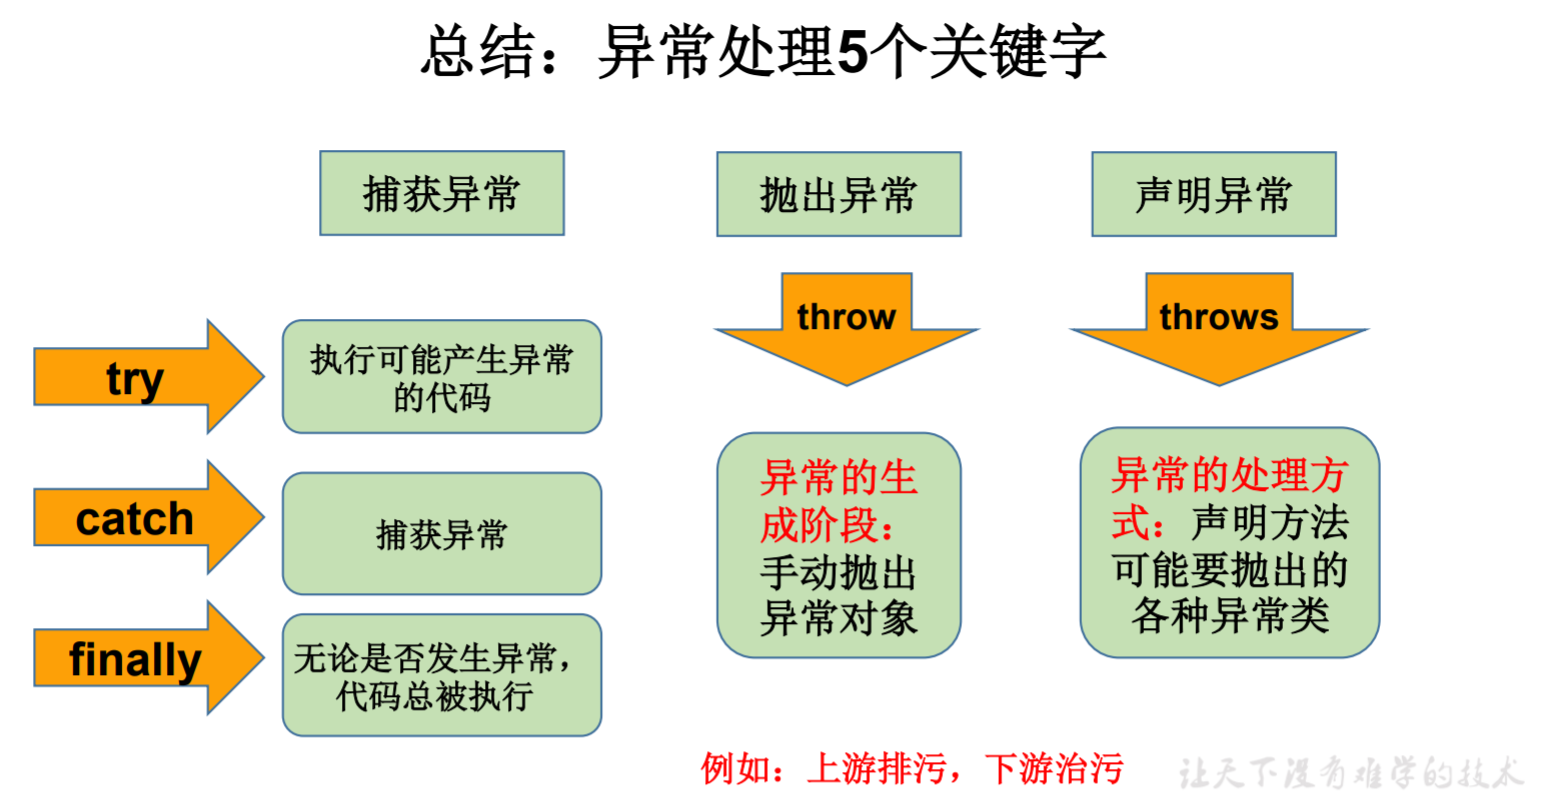
异常总结